Uno de los puntos más técnicamente específicos de la carta abierta sobre defensa colectiva en ciberseguridad es este:
“Construir herramientas de observabilidad y seguridad, garantizar las identidades agénticas son rastreables y responsables, y compartir las mejores prácticas en monitoreo continuo.”
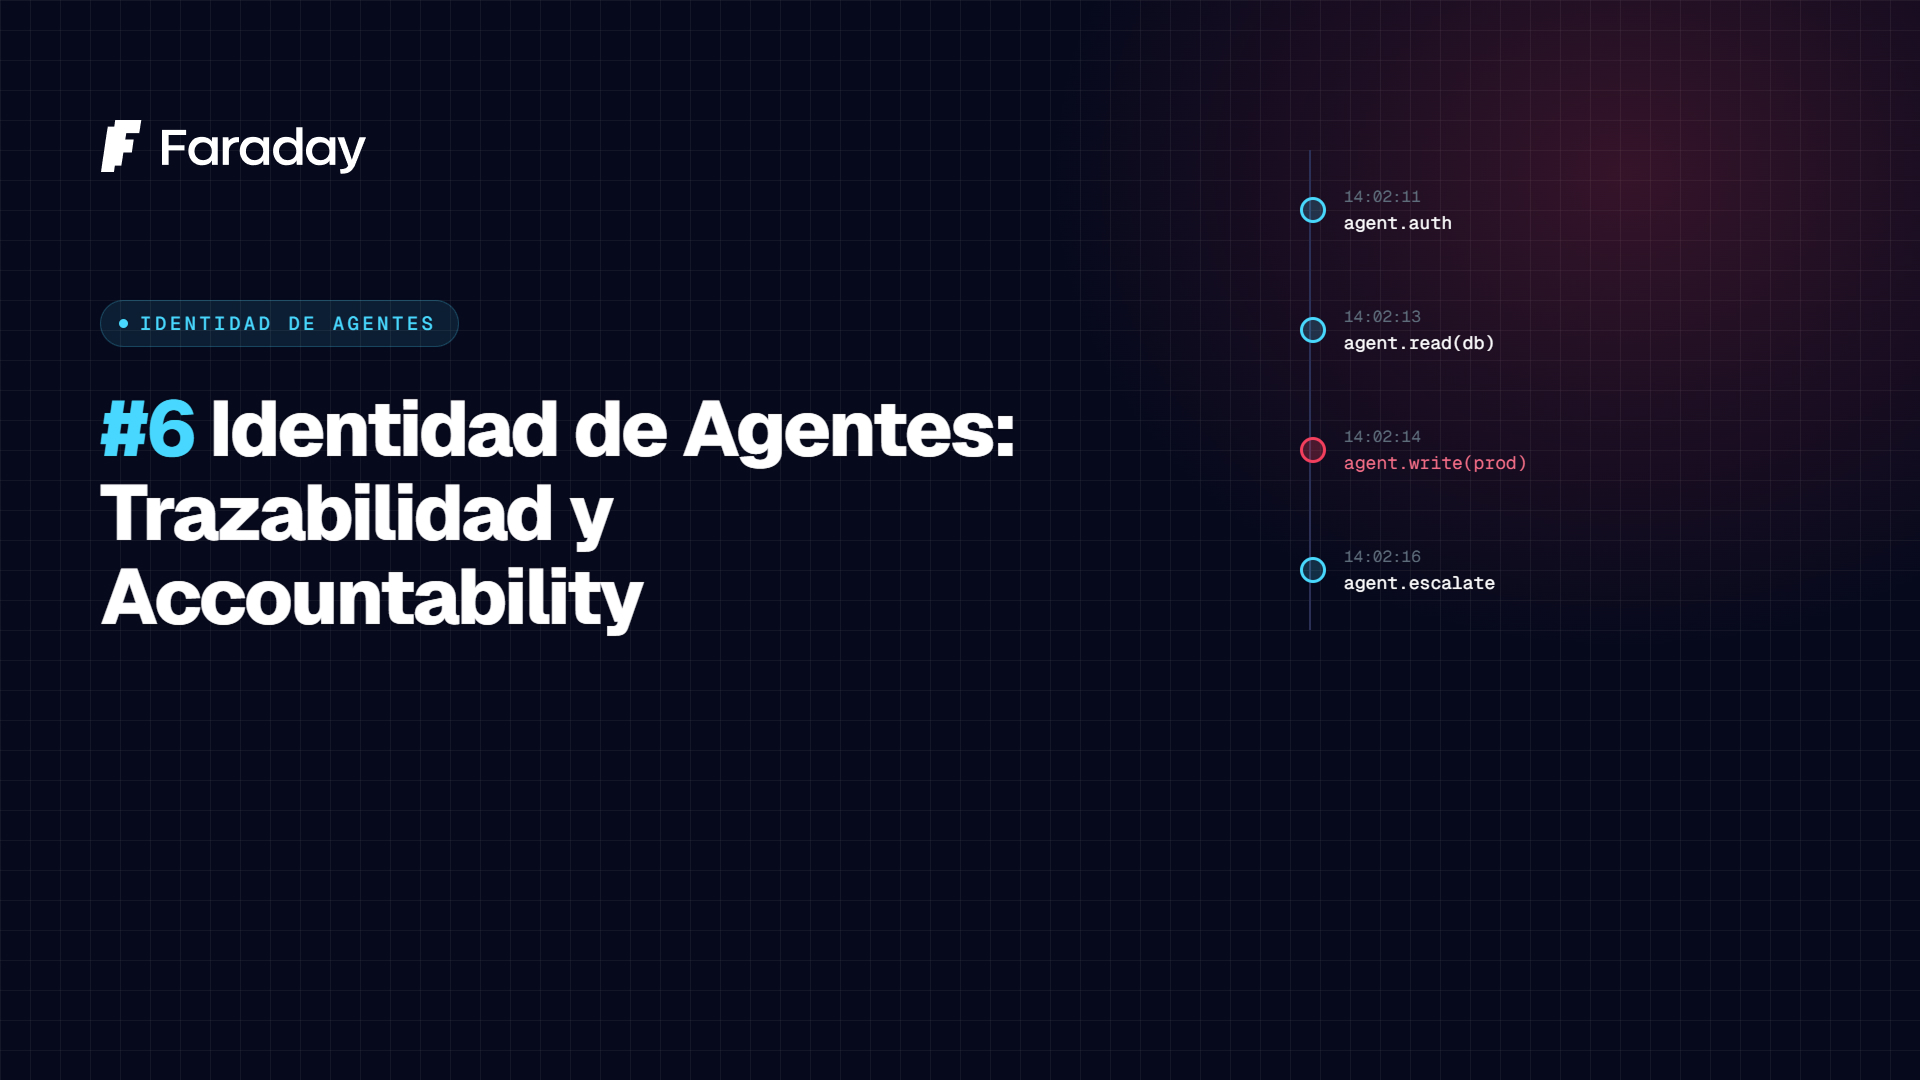
Es un problema relativamente nuevo para la mayoría de los equipos de seguridad: no se trata de auditar qué hizo un usuario humano o un service account tradicional, sino qué hizo un Agente de IA que actuó de forma autónoma o semi-autónoma, potencialmente encadenando múltiples llamadas a herramientas, sistemas y APIs. Esta guía es sobre cómo construir esa trazabilidad desde cero.
Por qué las identidades agénticas rompen los modelos de auditoría tradicionales
Un log de auditoría clásico responde "¿qué usuario hizo esta acción?". Con agentes de IA, la pregunta correcta es multinivel: ¿qué agente, invocado por qué usuario o proceso, con qué prompt o instrucción, ejecutando qué herramienta, con qué permisos heredados, y como parte de qué cadena de decisiones? Si tu sistema de logging no captura esos niveles, tenés una identidad no trazable — exactamente lo que la carta pide resolver.
Paso 1: Diseñar el modelo de identidad del agente
Antes de instrumentar nada, definí cómo se identifica un agente en tu sistema:
- Identidad única y persistente por agente (no reusar la misma credencial de service account para múltiples agentes con propósitos distintos).
- Vínculo explícito agente → dueño humano/equipo responsable.Todo agente tiene un owner, sin excepción — igual que un service account debería tenerlo hoy.
- Alcance de permisos scoped por tarea, no por sistema completo. Un agente de triage de alertas no necesita permisos de escritura en producción.
Paso 2: Instrumentar la cadena completa de decisiones
Para cada acción que ejecuta un agente, registrar como mínimo:
| Campo | Por qué importa |
|---|---|
| ID único de sesión/invocación | Te permite reconstruir la cadena completa de una tarea |
| Usuario o proceso que invocó al agente | Usuario o proceso que invocó al agente |
| Prompt/instrucción recibida | Contexto de por qué actuó así |
| Herramientas invocadas y parámetros | Qué acciones concretas ejecutó |
| Resultado de cada herramienta | Qué información recibió el agente para decidir el siguiente paso |
| Permisos efectivos en el momento de la acción | Auditoría de si actuó dentro de su scope autorizado |
| Timestamp de cada paso | Correlación temporal con otros eventos de seguridad |
json
{
  "session_id": "agent-run-8f2a1c",
  "invocado_por": "usuario:jsmith / servicio:incident-triage-pipeline",
  "identidad_de_agente": "agente:soc-triage-01",
  "equipo_propietario": "operaciones de seguridad",
  "pasos": [
    {
      "herramienta": "consultar_siem",
      "parametros": {"consulta": "alert_id:4471"},
      "marca de tiempo": "2026-08-30T14:02:11Z",
      "permisos_utilizados": "leer:siem"
    },
    {
      "herramienta": "isolar_host",
      "parametros": {"anfitrión": "srv-042"},
      "marca de tiempo": "2026-08-30T14:02:19Z",
      "permisos_utilizados": "escribir:aislamiento-de-red",
      "requiere_aprobacion": cierto,
      "aprobado_por": "humano:analyst_gperez"
    }
  ]
}
Paso 3: Accountability real: aprobación humana en acciones irreversibles
Trazabilidad sin control de accountability es solo un log bonito después del hecho. Para acciones con impacto irreversible o de alto riesgo (aislar un host de producción, revocar credenciales, modificar reglas de firewall), el diseño debe forzar:
- Punto de aprobación explícito antes de ejecutar, no solo registro posterior.
- Imposibilidad técnica de que el agente se auto-apruebe (separación de quien solicita y quien aprueba, igual que en controles financieros).
- Timeout y fallback seguro:si la aprobación no llega en tiempo razonable, el agente debe fallar de forma segura (no ejecutar por default), salvo en escenarios explícitamente pre-autorizados de baja criticidad.
Paso 4: Monitoreo continuo de comportamiento agéntico
Además del log de auditoría, instrumentá detección de anomalías específica para agentes:
- Desviación de patrón de uso de herramientas:un agente de triage que de repente invoca herramientas fuera de su set habitual es una señal de alerta (posible prompt injection o mal uso).
- Volumen anómalo de acciones:un agente ejecutando 500 acciones en un minuto cuando su baseline es 5 por minuto.
- Intentos de escalar permisos o acceder a recursos fuera de scope,que deberían bloquearse a nivel de política, pero también alertar si se intentan.
Paso 5: Compartir el modelo, no solo usarlo internamente
La carta pide explícitamente "share best practices in continuous monitoring". Si tu organización participa de un ISAC o grupo sectorial de intercambio de threat intelligence, considerá compartir (de forma anonimizada) patrones de comportamiento agéntico anómalo detectados — esto conecta directamente con el enfoque de defensa colectiva del post sobre threat intelligence sharing.
Checklist de implementación
- ☐ Asignar identidad única y persistente a cada agente, con owner humano explícito
- ☐ Instrumentar logging de cadena completa (invocación → herramientas → resultados → permisos efectivos)
- ☐ Implementar punto de aprobación humana obligatoria para acciones irreversibles
- ☐ Configurar fallback seguro ante timeout de aprobación
- ☐ Desplegar detección de anomalías de comportamiento agéntico (patrón, volumen, intentos de escalamiento)
- ☐ Evaluar qué patrones anonimizados podrían compartirse con tu ISAC o grupo sectorial
Parte de una serie sobre cómo poner en práctica los principios de Carta abierta de OpenAI sobre la defensa colectiva en ciberseguridad (Agosto de 2026). Volver a la guía completa.